这项技术如何降低知识蒸馏的显存占用?
文章提出两种方法:离线缓存教师模型每个位置最可能的前100个logits,训练时不再同时加载教师模型;以及融合分块KL损失,按序列块端到端计算投影和损失,不保留完整词汇×序列网格,反向传播时按需重算,峰值显存随序列长度线性增长。
(翻译)让知识蒸馏成本足够低以实现大规模运行

A Blog post by Multiverse Computing on Hugging Face
Multiverse Computing 提出两种系统优化,使大模型知识蒸馏可大规模运行:离线缓存教师模型前100个logits,避免训练时同时加载师生模型;融合分块KL散度损失,按块计算并丢弃中间结果,峰值显存显著下降。在32K上下文下显存减少15.6倍,256K上下文仍可运行,并将GPT-OSS 20B蒸馏从四个节点缩减至一个。
文章提出两种方法:离线缓存教师模型每个位置最可能的前100个logits,训练时不再同时加载教师模型;以及融合分块KL损失,按序列块端到端计算投影和损失,不保留完整词汇×序列网格,反向传播时按需重算,峰值显存随序列长度线性增长。
实验显示,四种设置在8K上下文下训练损失几乎重合,说明用缓存的前100个logits做离线蒸馏相对于在线蒸馏几乎无损。
在32K上下文蒸馏GPT-OSS 20B时,显存释放使配置从四个GPU节点缩减到一个,单步时间从57秒降至12.23秒,单卡吞吐从74.2提升至345.7 TFLOP/s。
 高瓴系 CFO 往事:一代顶级机构年轻人的迁徙与突围
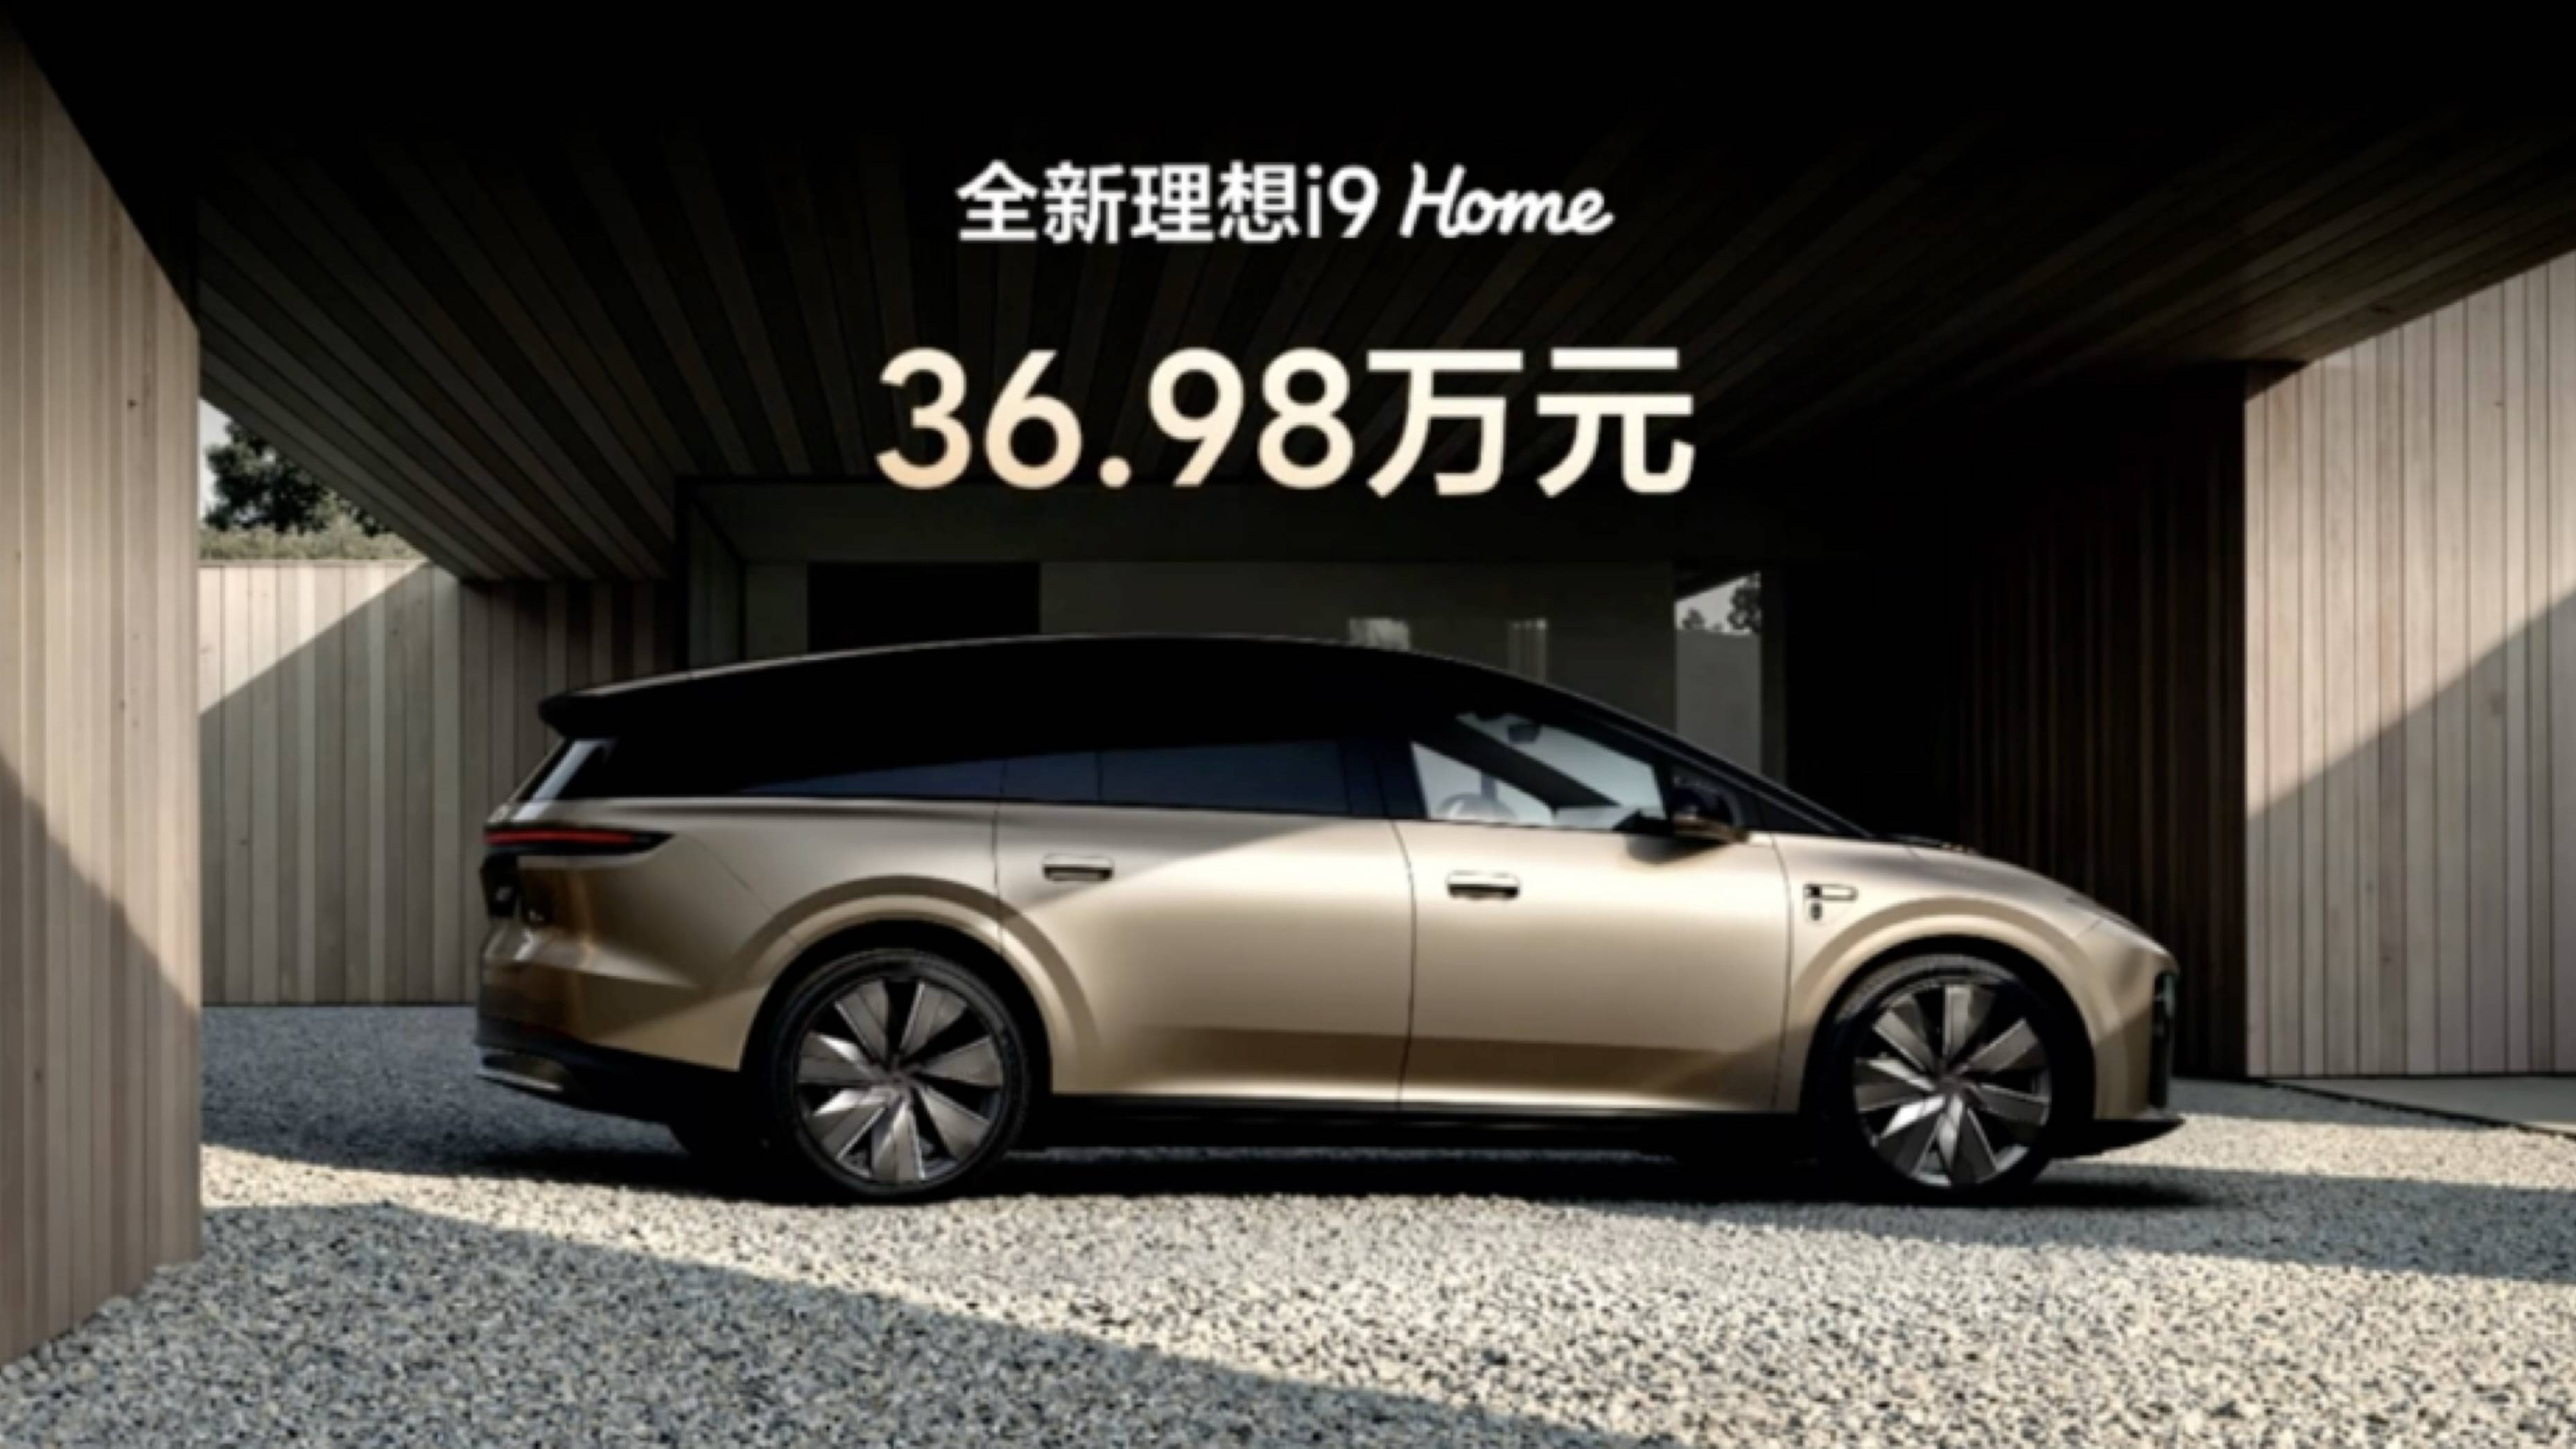 比 MEGA Home 便宜 14 万!理想 i9 Home 上市定价 36.98 万元,六座旗舰变天了廉价太阳能改变世界能源格局
 在金融支付系统中实施混沌工程:来自企业级 ECS 部署的经验教训
 2nm天玑9600 Pro,把旗舰SoC竞争推向「融合计算」
 产品经理的体面,是一块不能失守的 “括约肌”产品已批量进入全球头部Tier 1产线,「知来具身」要为工业场景打造“开箱即用”的泛化机器人华为GTS让Agent学会「看着网络排障」,双防火墙难题几乎全拿下
 推特创始人谈“AI减速”论:前沿不属于任何一家公司高性能电动船艇动力系统公司获近亿A轮融资,海外收入增长450%丨36氪首发企业案例分享:玉盘量智-离子阱量子计算芯片化集成工程实践 | 36氪 2026产业未来大会
 开学季 | 学生理财的三条建议,学生党也可以一样理财
 Cloudflare将每天90亿次请求的JavaScript CDN迁移到其开发者平台SDL3 移植到 HarmonyOS / OpenHarmony主题演讲:破界·量子计算迈向产业深水区——量子计算的下一公里|36氪2026产业未来大会清华稳准智能联合发布LimiX-2,结构化数据基础模型登顶国际评测榜单
 CoinShares Q2 挖矿季报:矿企倒贴钱退出
 月之暗面:网传创始人及员工信息系恶意造谣;OpenAI 放弃今年上市;iPhone Duo炒到9万,黄牛贷款欲囤货|AI周报
 产品定义意义上的一级场景:四维模型
 AI风口之下,明星们又想“挤上”牌桌了
 OpenAI 总裁最新采访:现在所有人对 AI 的预测,大概率都是错的
 Meta 打造“组织第二大脑”智能体的设计思路
 让 AI 补货,但不让它算库存——LangGraph 在生鲜补货的落地实践圆桌:生长·资方投资的新方程——穿越周期的耐心与价值 | 36氪 2026产业未来大会圆桌:探路·产业分工的新图谱,看到新未来——国家力量如何转化为产业价值 | 36氪 2026产业未来大会英国殖民之前的澳大利亚原居民人口约 222 万
 AI不会放缓圆桌:新能源:后时代的深水淘金 | 36氪 2026产业未来大会8点1氪丨选手赛中失禁污染赛道,HYROX中国宣布整改;机构预计美股明年将暴跌21%;苹果推出Siri人工智能
 GPT-6 Astra 之后,产品经理需要重新设计人在流程中的位置