NVIDIA FLARE 如何降低联邦多模态训练中的通信和内存压力?
NVIDIA FLARE 支持大型对象外部化、张量流式传输和磁盘支撑聚合,从而减少序列化、传输和聚合时占用的内存。
(翻译)使用 NVIDIA FLARE 构建联邦多模态 AI 工作流

Modern vision-language models (VLMs) can support tasks such as visual question answering, captioning, and image-text reasoning. In practice, however…
本文介绍使用 NVIDIA FLARE 构建联邦多模态 AI 工作流,重点讨论跨机构训练视觉语言模型时的网络传输与聚合设计,包括大型对象外部化、张量流式传输和磁盘支撑聚合。还介绍了 FedUMM 在冻结的 BLIP3o 骨干上仅聚合 LoRA 适配器,将每轮通信量从 28.6GB 降至 0.094GB,并提升 VQA v2 0.7 分。
NVIDIA FLARE 支持大型对象外部化、张量流式传输和磁盘支撑聚合,从而减少序列化、传输和聚合时占用的内存。
FedUMM 冻结 BLIP3o 多模态骨干,客户端只训练并上传 LoRA 适配器和对齐 token,服务器按模态聚合轻量更新。
在 8 客户端对比中,每轮通信量从 28.6GB 降至 0.094GB,VQA v2 提升 0.7 分,性能约为集中式参考的 97%。
 飞书与豆包工作合体后首亮相:Agent 能进群,还能帮你写周报、做PPT
 我的“一人公司”,是怎么搞钱的?产品已批量进入全球头部Tier 1产线,「知来具身」要为工业场景打造“开箱即用”的泛化机器人
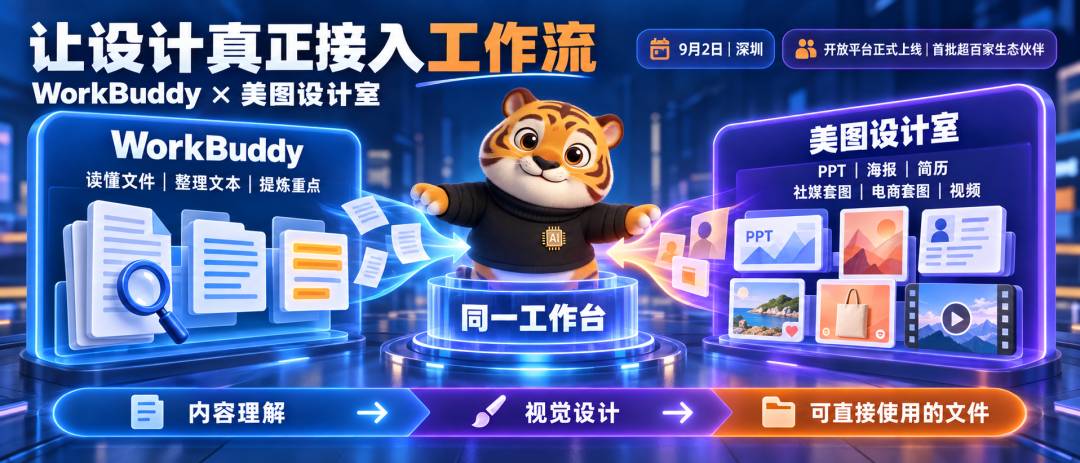 WorkBuddy + 美图设计室,在对话框里就能解决办公设计任务?
 QQ 飞车 Agentic 研发转型过程中的Loop Engineering
 就业率砍半,年轻人靠什么翻盘?AI时代,这三点越早做越好36氪首发 | 国内头部硅电容IDM企业融资亿元,切入AI芯片与高端光模块西门子不造机器人,为什么机器人进厂的故事里总有它?
 How NVIDIA Groq 3 LPX Deterministic Execution Drives Power-Efficient High-Interactivity Inference on NVIDIA Vera Rubin
 豆包 2.1 Pro模型更新,已接入豆包工作8点1氪丨选手赛中失禁污染赛道,HYROX中国宣布整改;机构预计美股明年将暴跌21%;苹果推出Siri人工智能8点1氪丨8月一线城市房价上涨;携程上架510万一张的太空旅行船票;字节跳动上半年净利润出现下滑,但海外收入占比再创新高
 金色Web3.0日报 | 黄仁勋批驳「AI末日论」
 渣打给ARB十美元目标价靠什么?
 AI for everyone in every language
 YC 最值钱的这 20家公司,没有一家来自最近5年FAST 发现极短周期、最轻双中子星系统
 CLARITY的失败 跟加密行业好坏没啥关系
 Scaling Federated Learning Across Docker, Kubernetes, and Slurm with NVIDIA FLARE前OpenAI后训练VP回应陶哲轩:说AI毁了数学,可能还是太小瞧AI了
 当罗永浩站在群众的对立面Windows 11 的 9 月例行安全更新再次引发了大量故障
 Arc主网上线 生态内有哪些项目?
 具透 | 精心优化, 体验感愉悦升华:iOS 27 中值得关注的新特性
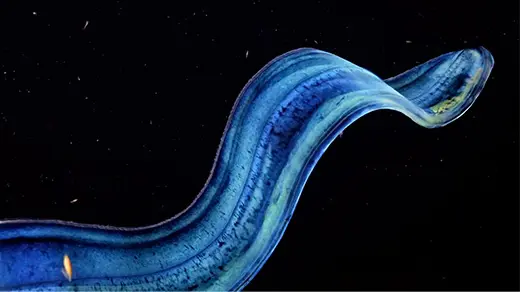 Ctenophores Aren’t Just Beautiful. They’re Biological Wonders.
 谁在给我们制造 AI 焦虑
 清晰法案有概率通过?市场可能并未定价
 苹果Siri AI上线;豆包手机助手消费版正式发布;塔克拉玛干沙漠发现两处大型地下水水源Mistral 与 Mozilla 合作推出 Firefox Smart Window7名博士生仅用3个月从零训练7B大模型:代码+数据+训练日志全公开