STEP-KTODER 的核心思路是什么?
STEP-KTODER 将代码生成中的步骤定义为多函数程序里的模块级函数,并用自动生成的单元测试为每个函数分配二进制的正确性标签,从而结合函数级过程监督和程序级结果反馈进行偏好优化。
(翻译)函数级执行反馈用于代码偏好优化
Abstract page for arXiv paper 2608.23632: Function-Level Execution Feedback for Code Preference Optimization
本文提出STEP-KTODER框架,将代码生成中的过程监督定义为多函数程序的模块级步骤,通过自动生成的单元测试为函数分配二进制正确性标签,并结合函数级过程监督与程序级结果反馈进行偏好优化。实验显示该方法在HumanEval、MBPP、BigCodeBench和LiveCodeBench上优于仅用结果级反馈的KTO与DPO,且执行标签比LLM判官标注更可靠。
STEP-KTODER 将代码生成中的步骤定义为多函数程序里的模块级函数,并用自动生成的单元测试为每个函数分配二进制的正确性标签,从而结合函数级过程监督和程序级结果反馈进行偏好优化。
在 HumanEval(+)、MBPP(+)、BigCodeBench 和 LiveCodeBench 上,STEP-KTODER 相比仅使用结果级反馈的 KTO 和 DPO 均取得了更好的性能。
研究发现,LLM-as-a-judge 的标注会系统性高估函数失败,污染正样本步骤标签并降低偏好优化效果,而基于执行的标签更加准确。
 特朗普“一再让步”:美国加密法案仍未过关
 OpenAI 总裁最新采访:现在所有人对 AI 的预测,大概率都是错的8点1氪丨8月一线城市房价上涨;携程上架510万一张的太空旅行船票;字节跳动上半年净利润出现下滑,但海外收入占比再创新高
 AI 负责创造,人来干脏活,这事儿能否停一下?
 展翼之后,三折叠再次进化:HUAWEI Mate XT 2 非凡大师深度体验评测
 HYROX比赛腹泻这事,运动员拼归拼,但主办方不能装看不见
 CLARITY法案为何倒在参议院门口?这主流如你所愿
 Opus 5.2深夜上线 RSI真来了?
 GPT-6 Astra实现具身智能突破 中国如何打具身防卫战
 微软 CEO 纳德拉:AI 应用的机会正在变大,模型成本将继续下降全球AI视频榜单第一梯队再添中国力量:智象发布首款物理规律导向视频模型Mozilla 报告称中国开放权重模型与美国前沿模型仅相差 4.4 个月
 实测豆包新模型2.1-pro,这次审美和长时间Agent任务都追上第一档了时光机器遭遇大规模机器流量36氪研究院 | 2026年北京市OPC创业者研究报告云岫资本合伙人宋旭文:量子计算:工程化与产业化并进,拐点将至 | 36氪 2026产业未来大会
 超级智能体“迪迪虾”上车,比亚迪携手阿里云推进智能座舱升级
 个贷不良四年涨 23 倍:这门从“救大行”长出来的生意,底层逻辑是什么?
 飞书与豆包工作合体后首亮相:Agent 能进群,还能帮你写周报、做PPT
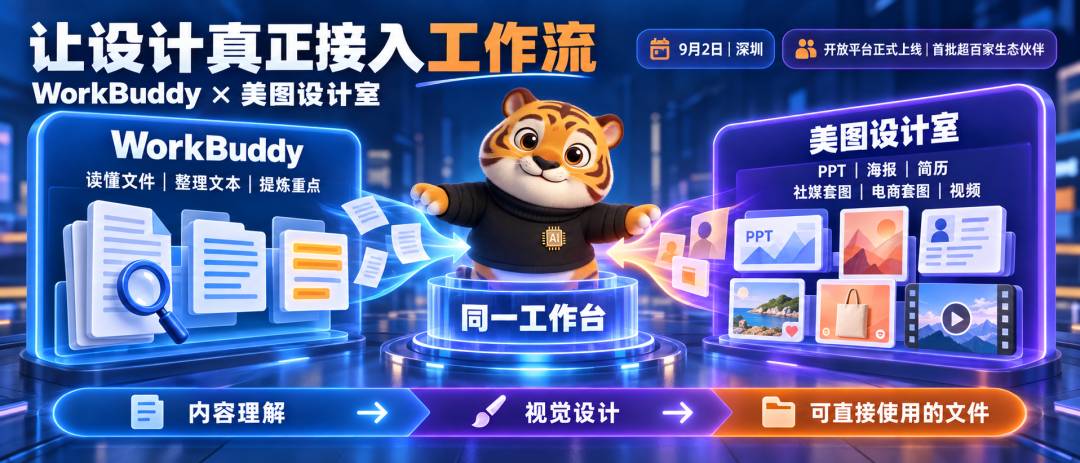 WorkBuddy + 美图设计室,在对话框里就能解决办公设计任务?
 无效的管理者和疲惫的基层:浅论考核指标的漂移
 我和我的 AI 手机吃了 3 顿饭
 场景越多 ≠ 产品越好,:从抽象价值到真实生活的定义结构
 破局产品同质化:长期主义的产品突围之路
 HIP-3:昂贵的入场券 买不来的护城河清华稳准智能联合发布LimiX-2,结构化数据基础模型登顶国际评测榜单2nm天玑9600 Pro,把旗舰SoC竞争推向「融合计算」
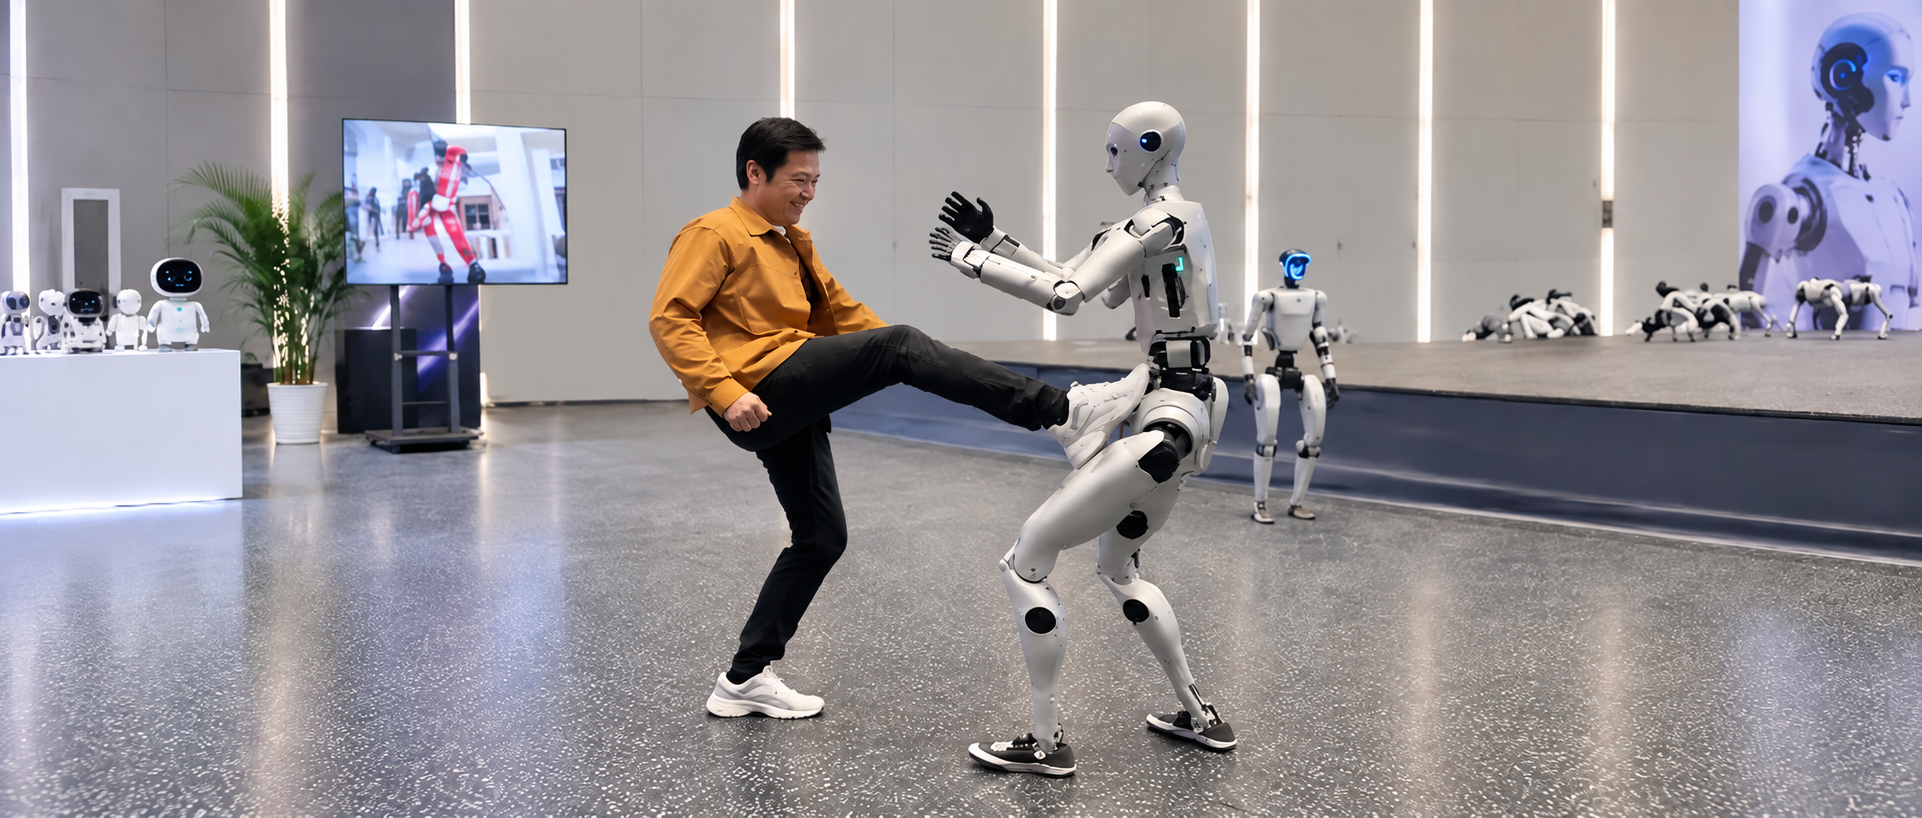 早报|雷军同日到访宇树与B站/罗永浩差评带来流量,野人先生单日涨粉近3万/鸿蒙智行确认问界合作调整,赛力斯主导产品已批量进入全球头部Tier 1产线,「知来具身」要为工业场景打造“开箱即用”的泛化机器人
 Stella:“显化”想要的人生,60天35万美元月收入