模型缓存如何减少推理冷启动时间?
它在 Pod 调度前将模型权重和容器镜像预加载到节点本地 NVMe 存储,Pod 启动时直接从本地读取(约 7 GB/s),无需从 Amazon ECR 或模型源下载。
(翻译)通过模型缓存减少 Amazon SageMaker HyperPod 上的推理冷启动
Amazon SageMaker HyperPod now supports model caching for inference, which pre-loads model weights and container images onto cluster nodes so pods read from local NVMe storage instead of downloading over the network. Learn how model caching cuts cold starts from tens of minutes to seconds, how it wor
AWS 为 Amazon SageMaker HyperPod 推理推出模型缓存功能,可在 Pod 调度前将模型权重和容器镜像预加载到节点本地 NVMe 存储,避免每次冷启动时从 Amazon ECR 和模型源下载。权重缓存读取速度约 7 GB/s,可将原本数十分钟的冷启动缩短到数秒;镜像缓存可节省 5-7 分钟拉取时间。支持 Amazon S3、Amazon FSx for Lustre、HuggingFace Hub 等来源,并提供回退机制。
它在 Pod 调度前将模型权重和容器镜像预加载到节点本地 NVMe 存储,Pod 启动时直接从本地读取(约 7 GB/s),无需从 Amazon ECR 或模型源下载。
权重缓存会下载模型权重到本地 NVMe,并等待所有目标节点就绪后才创建推理部署;镜像缓存则预拉取容器镜像,不阻塞部署创建,未命中缓存的节点会正常从 Amazon ECR 拉取。
支持 Amazon S3、Amazon FSx for Lustre、HuggingFace Hub 以及 Amazon SageMaker JumpStart(包括非门控和门控模型)。
 基元律动与无问芯穹达成战略合作,推进高质量Token供给与应用
 Robinhood的财富效应
 在金融支付系统中实施混沌工程:来自企业级 ECS 部署的经验教训
 苹果Siri AI上线;豆包手机助手消费版正式发布;塔克拉玛干沙漠发现两处大型地下水水源
 从入门到精通,一篇文章带你入门产品经理!(2026 年最新版)PS2 Fat 使用的安全芯片在时隔 26 年被破解英伟达开源 IMO 金牌配方:不仅是「人海战术」,1.5TB 显存做实 AI「 推恩令」?
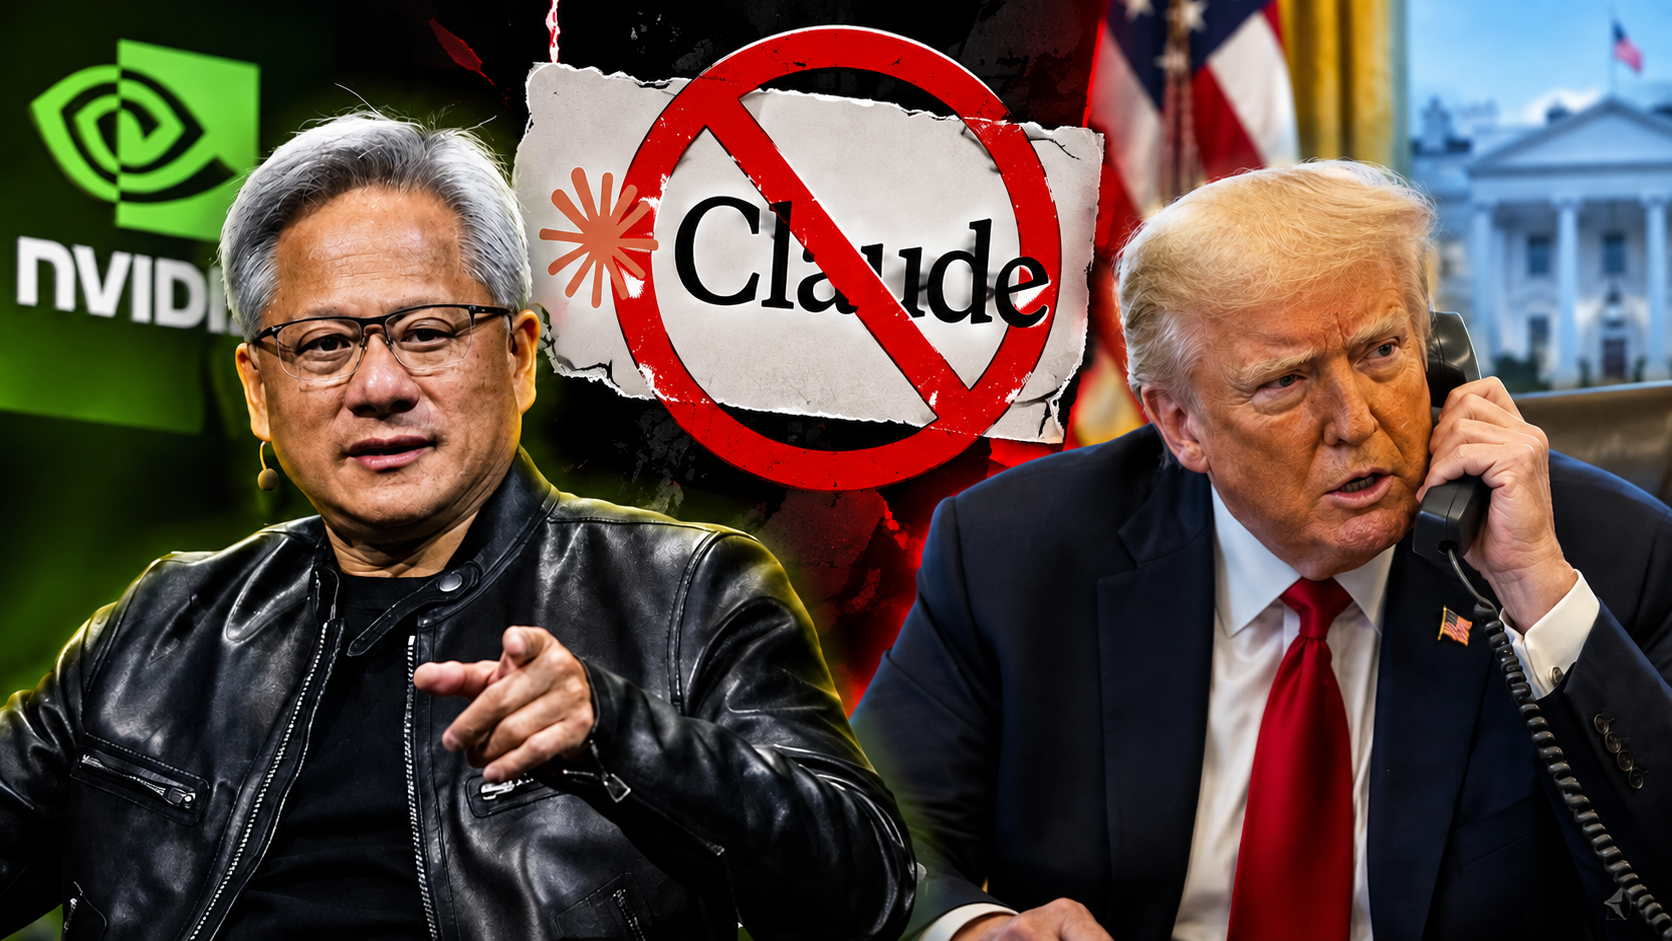 Claude在英伟达内部被限用,黄仁勋告诉特朗普:我们不会让AI发展放缓发生
 从200亿收购失败到650亿IPO:Figma如何用“协作”颠覆设计帝国
 这种国民鱼一直被低估、被当廉价鱼!现在才知道钙和 DHA 这么多!快试试清华稳准智能联合发布LimiX-2,结构化数据基础模型登顶国际评测榜单圆桌:智能向实,产业向新——AI如何进入真实世界 | 36氪 2026产业未来大会
 当罗永浩站在群众的对立面企业案例分享:玉盘量智-离子阱量子计算芯片化集成工程实践 | 36氪 2026产业未来大会超级智能体“迪迪虾”上车,比亚迪携手阿里云推进智能座舱升级首个AIGC长片大赛!RunningHub单项大奖100万,科幻IP免费改编产品已批量进入全球头部Tier 1产线,「知来具身」要为工业场景打造“开箱即用”的泛化机器人
 语义翻译的操作日常:把”我觉得不对”变成”机器能查”
 企业该买模型还是养上下文?
 129亿美元卖身英伟达之后,是时候重新理解Hugging Face了手机替我跑了一整套流程!我就说了一句话,AI执行了100步不止一颗CPU?智能体经济时代,Arm对算力平台有了新理解
 缓存不该困在一台服务器里
 百度做了一堆AI产品,却没有一个能代表百度?
 视频号评论区小蓝词使用指南
 拼多多链接裂变玩法圆桌:CVC的全面崛起 | 36氪 2026产业未来大会
 New insights from Google’s AI & Economy ATLAS
 稳定币挤兑与套利集中化英伟达带动AI数据中心大变革,中国厂商不想当边缘人